10 минсентября 9, 2026

Наши инструменты отслеживают миллионы рекламных кампаний в форматах native, push, pop и TikTok.
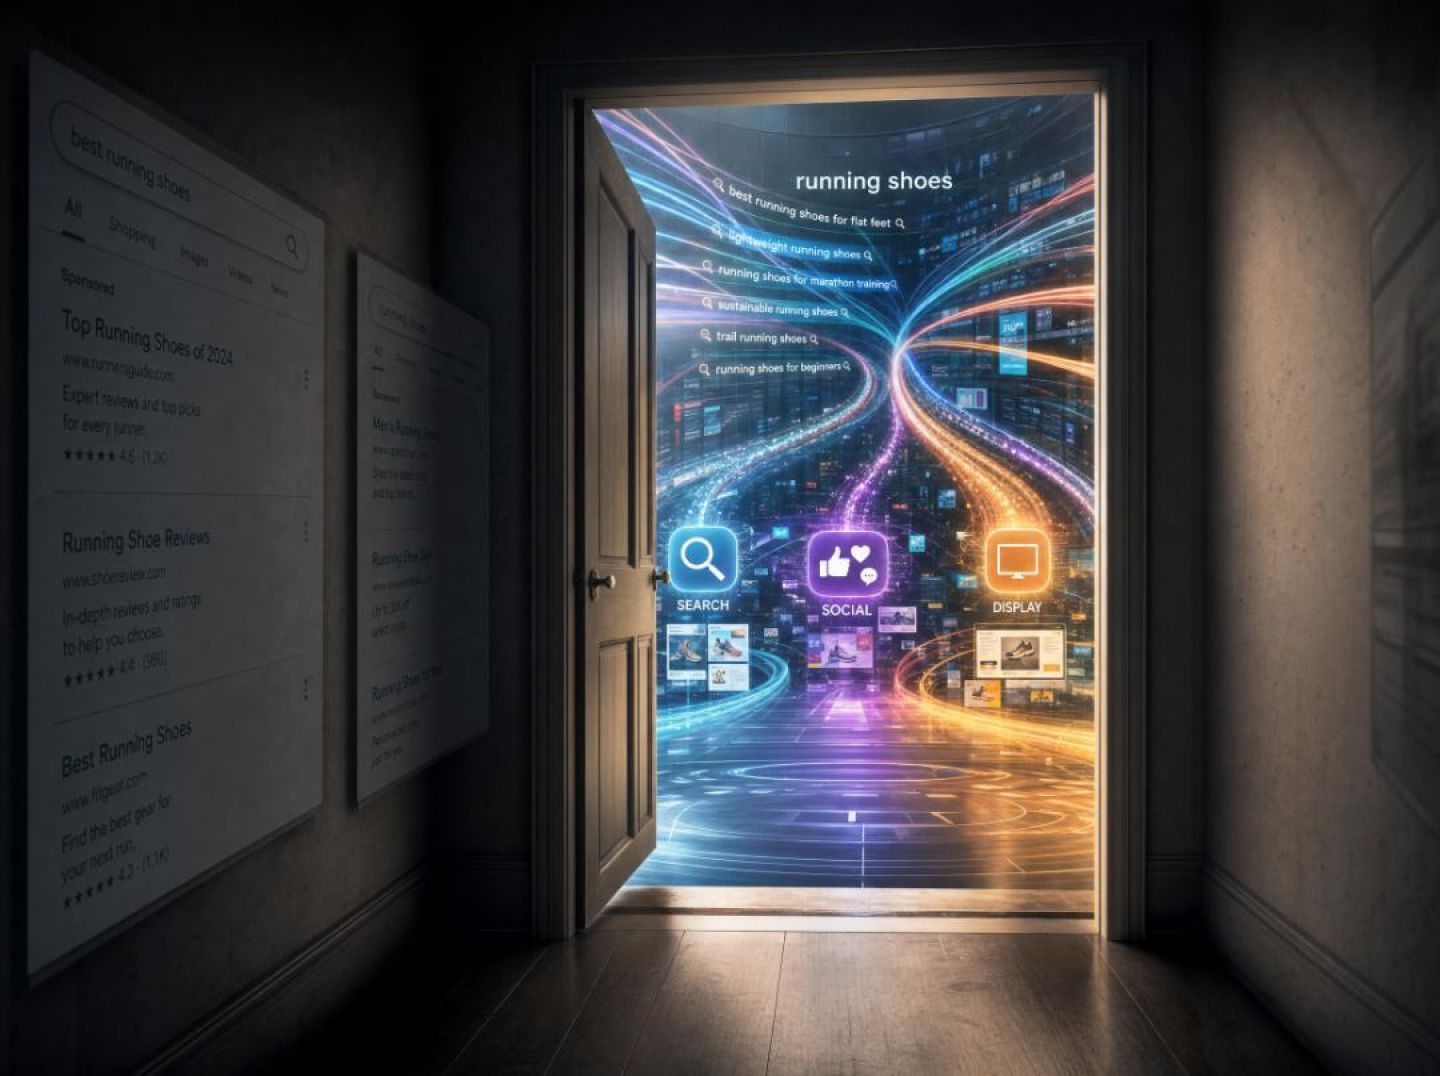
НачатьИИ-поиск не просто “забрал” часть вашего органического трафика. Он незаметно переместил весь процесс покупки в другую комнату, а большинство маркетологов по эффективности до сих пор оптимизируют старый коридор.
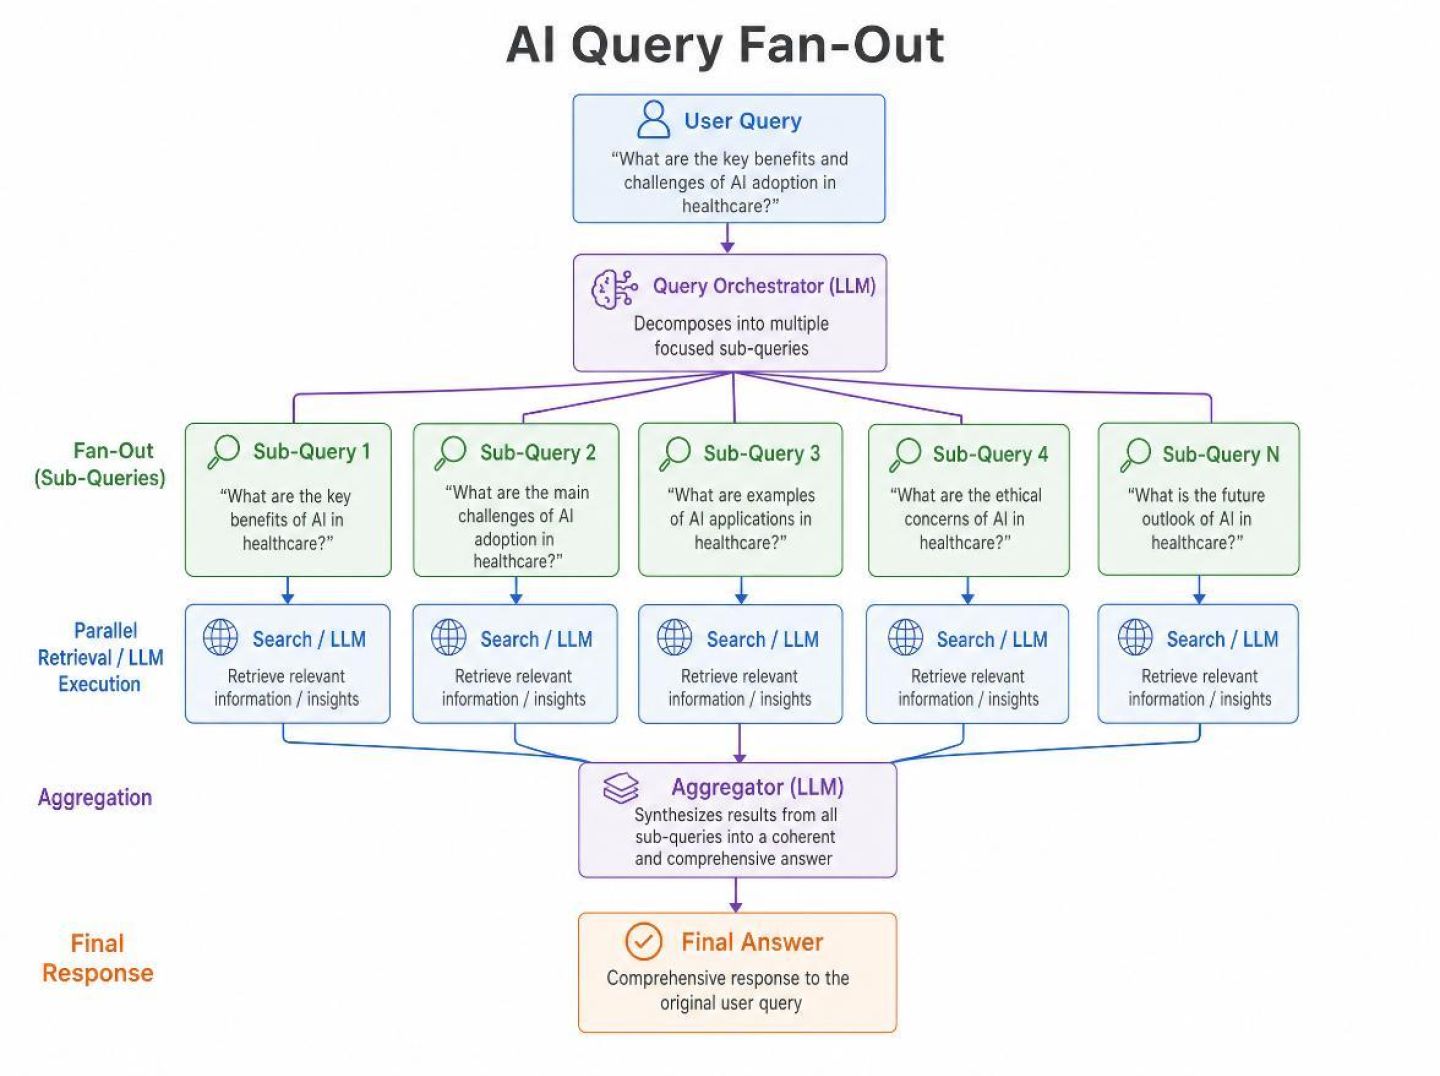
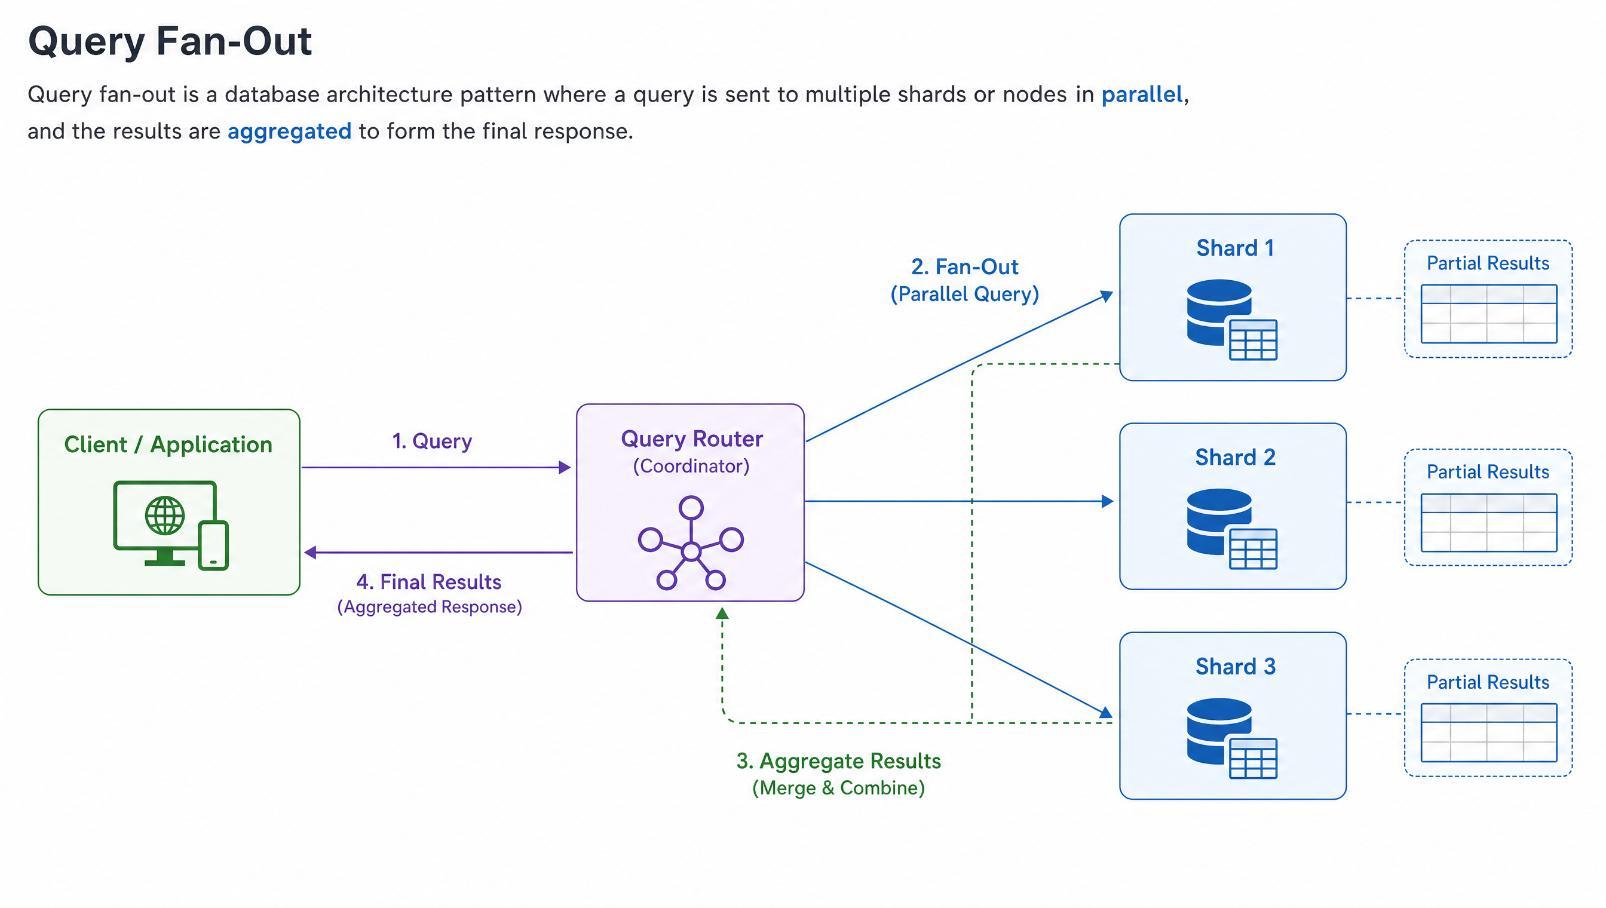
Когда покупатель вводит в Gemini или ChatGPT запрос “lучшая платформа электронной почты для B2B-команды из 5 человек с жесткими требованиями к безопасности”, он больше не выполняет один поиск. В фоновом режиме движок разбивает этот один запрос на дюжину подзапросов—таких как “B2B маркетинг по электронной почте инструменты,” “платформы электронной почты с сертификатом SOC 2,” “автоматизация электронной почты для небольших команд,” и “сравнить HubSpot и Klaviyo для B2B”—и одновременно подбирает результаты по всем этим запросам. Это и называется расширением запроса.
Как исследование Semrush о расширении запросов, так и анализ AI-обзоров от Contently объясняют, что именно модель расширения лежит в основе работы AI-обзоров Google и поисковых систем в стиле LLM. Система определяет все скрытые в запросе намерения, параллельно запускает группу связанных поисковых запросов, оценивает, какие страницы наилучшим образом соответствуют каждому микронамерению, а затем объединяет лучшие фрагменты в один синтетический «ответ». Покупатель видит один плавный ответ; на самом деле движок уже прошёл весь ваш воронок продаж.
В этом и заключается реальная угроза — и возможность. Ваши платные и органические стратегии по-прежнему построены вокруг отдельных ключевых слов и линейных путей: ключевое слово для осведомлённости → ключевое слово для рассмотрения → брендированное ключевое слово → клик → целевая страница → воронка. Однако теперь пользователи проходят весь этот путь непосредственно в окне чата. Согласно исследованию HubSpot поведения пользователей при поиске с ИИ, решения на базе ИИ самостоятельно отвечают на «простые» вопросы, а пользователи, которые всё же переходят по ссылкам, приходят намного позже в цикле принятия решения — с коэффициентами конверсии, превышающими в 3 раза показатели других каналов.
Ваши метрики вводят вас в заблуждение. Снижение органических кликов не означает снижение спроса; это говорит о том, что этапы поиска, обучения и сравнения сворачиваются в многоцелевые запросы, которые вообще не доходят до вашего сайта. К тому моменту, как кто-то попадает на вашу страницу из ChatGPT или Gemini, он уже подтвердил наличие своей проблемы, просмотрел синтезированное сравнение и бессознательно усвоил, какие бренды ИИ считает достойными упоминания. Это уже не посетитель «верхней воронки» — это покупатель со своим коротким списком.
В то время как SEO-команды пытаются адаптировать контент под эту новую реальность, маркетологи эффективной рекламы продолжают пребывать в оцепенении. Ваши поисковые кампании по-прежнему предполагают строгое соответствие между ключевым словом, объявлением и целевой страницей. Между тем Google уже использует те же поисковые объявления в качестве креативного материала для экспериментов в Gemini; как отмечается в отчёте Search Engine Journal об ИИ-поиске для бизнеса, платформа охотно смешивает ваши существующие материалы, чтобы проверить, что работает внутри её ИИ-сервисов. Вы думаете, что просто оптимизируете RSA-объявления; Google считает, что обучает поисковую систему ответов.
Маркетологи, которые выиграют в следующей волне, будут не те, кто напишет немного лучший рекламный текст для «лучшего программного обеспечения для управления проектами». Это будут те, кто научится подсматривать за самим процессом разветвления запросов: как ИИ разбивает их ключевые коммерческие термины на подзапросы сравнения, рисков, функций, вариантов использования и «следующего шага», а затем будет отражать эти аспекты в своей рекламной стратегии.
Вместо того чтобы гадать, как выглядит «этап исследования» или «этап принятия решения», вы можете выполнить обратную инженерию реального процесса: фактический кластер подзапросов, которые ИИ запускает, когда кто-то находится на грани покупки. Как только вы увидите эту структуру, вы сможете создать рекламные группы, креативы и целевые страницы, которые будут соответствовать тем намерениям, которые движок уже выделяет и перекомбинирует в своих ответах.
Другими словами, перестаньте оптимизировать для линейного пути, который пользователи оставили сразу, как только ИИ стал их стандартным помощником в поиске. Сейчас игра заключается в том, чтобы подслушивать, как думает помощник — как он разветвляет один вопрос в сеть микро-намерений — и затем делать свою рекламу очевидным выбором в каждом узле этой скрытой карты.
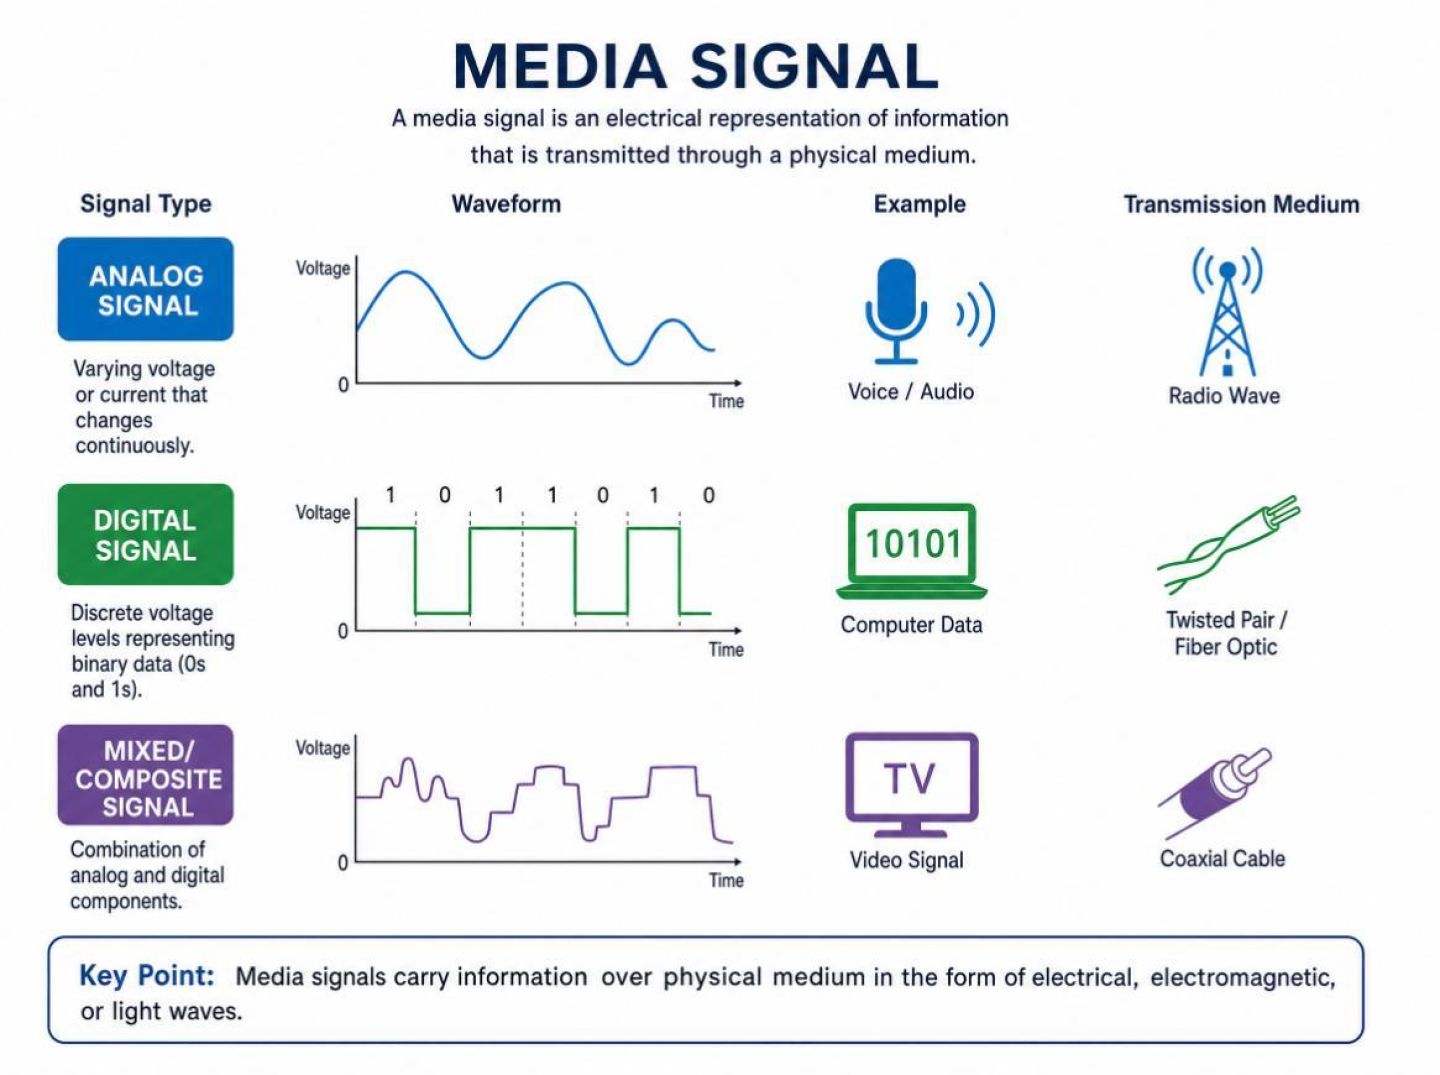
Большинство команд по-прежнему рассматривают множественное распространение запросов как экзотическую SEO-концепцию. Но это не так. Это медиасигнал, который теперь определяет, где именно появляются ваши рекламные бюджеты — независимо от того, покупаете ли вы поисковую, социальную или программную рекламу.
Системы поиска на базе ИИ не «отвечают на вопросы». Они запускают рекламные кампании за микросекунды.
Когда кто-то вводит в ИИ-помощник запрос вроде "лучшая платформа электронной почты B2B для маркетинговой команды из 5 человек со строгими требованиями к безопасности", модель не обращается к вебу ни разу. Она разбивает этот запрос на группу поисковых запросов, ориентированных на определённые цели: цены, отзывы, системы безопасности, чек-листы интеграции и аспекты сравнения, а затем одновременно выполняет поиск по всем этим направлениям в масштабе. Как объясняют специалисты Ahrefs в своём разборе расширенного генерирования с поиском, помощник декомпозирует запрос, параллельно запускает несколько поисковых операций, оценивает результаты и затем объединяет пересекающиеся наилучшие результаты в окончательный ответ.
Раньше этот этап «распределения» целиком относился к миру SEO: какие страницы будут найдены, цитированы или суммированы. Но когда Gemini, Copilot и ChatGPT начали работать на платформах с рекламной финансовой моделью, те же сигналы распределения стали проникать в вашу платную рекламу.
Если вы воспринимаете распределение запросов как усовершенствованную функцию поиска ключевых слов, то упустите суть изменений. Более точная модель восприятия: распределение запросов — это граф намерений, управляющий как органичесным, так и платным охватом.
Несколько факторов превращают это в медиа-сигнал, а не просто в SEO-сигнал:
1. Распределение запросов на основе ИИ определяет, в какие аукционы вы вообще попадаете.
В классическом поиске ключевые слова служат узким местом. Если вы не делали ставки на запрос «email-провайдер, соответствующий SOC 2», вы никогда не показывались бы по нему. В мире, ориентированном на ИИ, пользователь может вообще никогда не ввести «SOC 2». Ассистент определяет намерение, связанное с безопасностью, и запускает в фоновом режиме подзапросы, такие как «платформа email-маркетинга с SOC 2» и «email-поставщик, соответствующий HIPAA», как ясно показано в обзоре Semrush о распределении запросов. Эта скрытая сеть подзапросов теперь служит фильтром перед аукционом: если ваш контент или бренд отсутствуют в тех источниках, которые затрагивают эти подзапросы, ваши объявления никогда не получат шанса конкурировать — даже в кампаниях с широким соответствием или нацеленных на аудиторию.
2. «Присутствие в ИИ» — это не просто органический KPI.
Большинство маркетологов, стремящихся попасть в ИИ, зацикливаются на упоминаниях: «Нас упомянули в блоке ответа?» Но, как указывает Нил Патель в разборке предпочтений источников ChatGPT, истинная сила сосредоточена выше по течению, в корпусе распространения — в том, что модель выбирает искать в первую очередь. Когда AI-ассистенты станут стандартной отправной точкой для поиска, именно этот верхний уровень составит пул, питающий рекламные модули, партнерские места и любые другие монетизируемые форматы, которые платформы внедрят дальше. Если вы измеряете только органические упоминания, вы не видите, где ваш охват за счет платного трафика незаметно сужается.
3. Распространение (fan-out) возвращает вам «середину воронки», которую вы, как думали, потеряли.
Небольшие издатели уже чувствуют давление: реферальный трафик снизился более чем наполовину в некоторых сегментах, поскольку обзоры ИИ отвечают на вопросы прямо в выдаче, согласно анализу Нила Пателя снижения реферального трафика. Однако тот же анализ демонстрирует, что транзакционный контент и контент с высоким намерением по-прежнему получают клики, потому что ИИ не может замкнуть все цепочки. Это и есть новый мост между ИИ и платной рекламой: распространение сильно опирается на более глубокий, узкоспециализированный контент для синтеза, а затем передаёт трафик на объявления и товарные страницы, как только намерение купить достигает пика. Если ваш бренд не представлен на всех этих расщеплённых намерениях, ваши списки ретаргетинга, коэффициенты соответствия и аудитории внутри платформ сокращаются.
4. Вам больше не нужно “побеждать в SERP”, чтобы получить показ.
Один из важнейших выводов исследований о распределении запросов (fan-out) заключается в том, что попадание в топ-10 теперь необязательно. Системы ИИ извлекают фрагменты текста, а не целые страницы, и зачастую берут данные с URL, находящихся глубоко в обычной выдаче. По данным Backlinko, ChatGPT использует URL с позиций 21 и ниже почти в 90% ответов, при этом значительная доля ссылок берётся из первых 30% страницы, поскольку модель быстро просматривает текст в поисках лёгких для извлечения ответов, согласно их исследованию распределения запросов и видимости в ИИ. Для специалиста по performance-маркетингу это кардинально меняет картину: контент, который ранее не оправдал бы отдельную статью бюджета на SEO, может стать решающим “источником истины”, формирующим как ответы ИИ, так и контекстные сигналы с аудиторией, которые используют ваши рекламные платформы.
5. Распределение запросов (fan-out) теперь является частью стратегического планирования, а не просто артефактом позиций в выдаче.
Инструменты вроде Brand Radar от Ahrefs и экспериментальные платформы, представленные в обзоре fan-out от WordStream, уже показывают вложенные запросы, которые генерируют системы ИИ. Эти данные структурно ближе к медиа-брифу, чем к SEO-отчёту: они показывают, как реальные покупатели описывают свои проблемы, какие уточнения добавляет ИИ (например, “lучший”, “2026”, “обзоры” или “Reddit”), а также какие смежные категории попадают в тот же путь исследований. Эти данные становятся основой для построения аудитории, создания рекламных текстов и выбора угла подачи на целевых страницах—а не просто подтигов к страницам.
Вывод: распределение запросов (fan-out) теперь служит связующим звеном между тем, как думают люди, как ИИ интерпретирует эти мысли и где ваша реклама может логично появляться. Если вы продолжаете считать это просто “SEO-темой”, вы оптимизируете пустой коридор, в то время как путь покупателя и важные аукционы уже переместились в другую комнату.
За этим многословным запросом к Gemini или ChatGPT вы видите не “результат поиска”. Вы наблюдаете процесс планирования.
Когда покупатель вводит “lучшая платформа электронной почты B2B для маркетинговой команды из 5 человек со строгими требованиями к безопасности”, ИИ не просто ищет именно эту фразу и не выбирает несколько синих ссылок. Он разбивает запрос на сеть связанных поисковых операций—то, что Робби Стайн из Google описал как превращение одного запроса в “десятки и сотни” фоновых поисковых операций в рамках технологии Deep Search, механизм, который команда WordStream описывает как основу современного расширения запросов.
На практике в системах поиска с ИИ происходит следующее:
Исследование, обобщённое Ahrefs по теме генерации с извлечением данных, показывает, что ChatGPT, Perplexity, Gemini и Copilot выполняют все эти запросы в виде реальных веб-поисков, а затем используют полученные результаты как основу для работы модели.
3. Извлечение и повторная сортировка.
Каждый подзапрос возвращает свою мини-выдачу. Затем ИИ ищет страницы, которые последовательно появляются во многих из этих списков и, похоже, в большей степени соответствуют группе намерений, чем альтернативы. Как отмечается в анализе Semrush поведения распределения запросов, системы, как правило, вознаграждают контент, охватывающий совокупность связанных подвопросов, а не только ключевое слово в заголовке.
4. Синтез и цитирование.
Только после извлечения LLM “формулирует” ответ. Он берёт факты, утверждения и примеры из отобранных URL и объединяет их в единое повествование. Источники, которые вы видите в цитатах, или бренды, упомянутые без ссылки, — это «выжившие» участники этого многозапросного турнира.
Это и есть распределение запросов. И оно принципиально отличается от линейных воронок покупателей, которые до сих пор используются многими маркетинговыми командами.
Традиционное картирование воронки предполагает последовательность отдельных шагов: ключевое слово осознания → ключевое слово рассмотрения → ключевое слово сравнения → брендовое ключевое слово. Вы планируете рекламу, как воронку упорядоченных поисковых запросов и точек взаимодействия. Но распределение запросов сворачивает эту воронку в один детализированный момент.
В одном запросе ИИ исследует:
Вместо того чтобы ждать, пока покупатель пройдёт через множество поисковых запросов и каналов, помощник заранее выполняет весь этот путь исследования за него. Как начали замечать маркетологи предприятий в исследовании Search Engine Journal об ИИ-поиске, это изменение означает, что “на каком этапе” находится покупатель в воронке теперь отражается в одном запросе к ИИ с высокой целевой направленностью.
Для маркетологов, ориентированных на результат, последствия очевидны:
Суть в следующем: массовый опрос превращает каждый серьезный запрос ИИ в сжатое многократное покупательское путешествие. Ваша старая карта пути покупателя неверна не потому, что клиенты изменили свое мнение; она неверна, потому что интерфейс, выполняющий поиск, теперь выполняет все эти «шаги» параллельно, прежде чем вы войдете на аукцион.
ИИ изменяет не только порядок ранжирования страниц. Он меняет сам способ, которым покупатели формируют свой “ментальный короткий список” ещё до того, как они посетят ваш сайт или увидят вашу рекламу.
В старом мире этот список формировался по последовательности, которую можно было изобразить на доске: поиск → просмотр результатов → несколько кликов → возможно, переход в социальные сети → возврат через ретаргетинг. Сейчас же короткий список заранее собирается внутри поисковых систем и лент социальных сетей на основе ИИ, после чего передаётся покупателю так, будто он сам его обнаружил.
Когда кто-то задаёт ИИ-поиск с запросом вроде «лучшая B2B-платформа для электронной почты для команды маркетологов из 5 человек со строгими требованиями к безопасности», система разбивает этот один запрос на десятки подзапросов, находит результаты, а затем сводит их к единственному ответу. Как объясняет команда Ahrefs в своём разборе генерации с расширенным извлечением, модель не анализирует весь интернет; она изучает лишь те страницы, которые стабильно появлялись в результатах скрытых подзапросов, и использует их для формирования ответа.
Этот ответ ИИ не является нейтральным. Он:
К тому времени, как покупатель дочитывает до конца, у него уже формируется неявный набор сравнений в голове—даже если он перешёл всего по одной ссылке. Как показало исследование HubSpot поведения при поиске с помощью ИИ, посетители, пришедшие через ИИ, зачастую уже “прошли начальную фазу поиска”, поскольку они заранее подтвердили наличие проблемы и видели, какие поставщики упоминаются в сводке.
Если ваш бренд не упомянут в первоначальном обзоре ИИ—даже если вы хорошо ранжируетесь по связанным ключевым словам—ваши шансы попасть в мысленный шорт-лист резко падают. Как отмечает Contently в своей статье о том, почему ваша лучше всего ранжируемая страница может быть невидима для ИИ Google, место в первой строке по запросу не гарантирует появления в развернутом ответе, который фактически формирует результат. Видимость внутри движка ответов, а не только на странице результатов поиска (SERP), теперь определяет, окажетесь ли вы “в комнате”, когда формируется шорт-лист.
Обратная связь этим не ограничивается. Каждый ответ ИИ тонко подсказывает покупателю, какие действия он предпримет дальше.
Когда ИИ даёт структурированный ответ — «Вот три платформы, которые стоит рассмотреть», с указанием плюсов, минусов и дальнейших шагов — он формирует следующий набор идей, которые пользователь начнёт искать или о которых спросит:
Эти последующие поисковые запросы выглядят как независимые действия, но они зависят от формулировки и ссылок, предложенных ИИ. И поскольку ИИ-сервисы Google, такие как ChatGPT или Perplexity, самостоятельно генерируют новые запросы на основе каждого нового вопроса, ваш шанс быть замеченным сужается или расширяется в зависимости от того, продолжаете ли вы появляться среди этой изменяющейся группы подзапросов.
Подробный анализ компании WordStream по теме расширения запросов выявляет этот накопительный эффект: страницы, которые многократно появляются в связанных подзапросах, чаще упоминаются, что в свою очередь обучает модели считать эти бренды “nадежными”, чтобы рекомендовать их снова в будущих ответах. Именно так небольшая группа поставщиков становится стандартными рекомендациями для тысяч слегка отличающихся запросов.
Тем временем, социальные платформы сами участвуют в формировании намерений.
Ваш покупатель переходит из результата ИИ в LinkedIn, X или YouTube, чтобы «проверить на вменяемость» то, что он только что увидел. Но лента — это не нейтральная выборка мнений рынка; это настроенная на вовлечение копия тех же брендов и подходов, которые ИИ уже выделил.
К тому времени, как ваш потенциальный клиент перескочит с обзора ИИ на несколько сравнительных статей и несколько видео создателей, его умственный короткий список кажется составленным самостоятельно, но на самом деле в значительной степени предварительно создан взаимодействием между поисковыми системами, ориентированными на широкое распространение, и лентами, оптимизированными для вовлеченности.
Маркетологи предприятий уже ощущают последствия. В ходе опроса 300 руководителей о внедрении поиска на основе ИИ, отчет Search Engine Journal о поиске на основе ИИ в 2026 году показал, что многие выделяют значительный бюджет на решения с использованием ИИ именно потому, что видят, насколько сильно эти инструменты влияют на открытие и выбор, даже когда атрибуция неясна.
Для маркетологов, ориентированных на результат, это означает, что ваш «реальный» конкурентный набор определяется на раннем этапе, ещё до запуска кампаний:
Ваши объявления, целевые страницы и ретаргетинг работают не на пустом месте; они работают поверх этой модели восприятия, сформированной ИИ. Если вас нет в кругу распространения, который определяет как сводки ИИ, так и выдачу поисковых систем, вы вынуждены бороться, пытаясь вытеснить конкурентов, уже вписанных в эту историю до того, как ваше объявление хотя бы загрузилось.
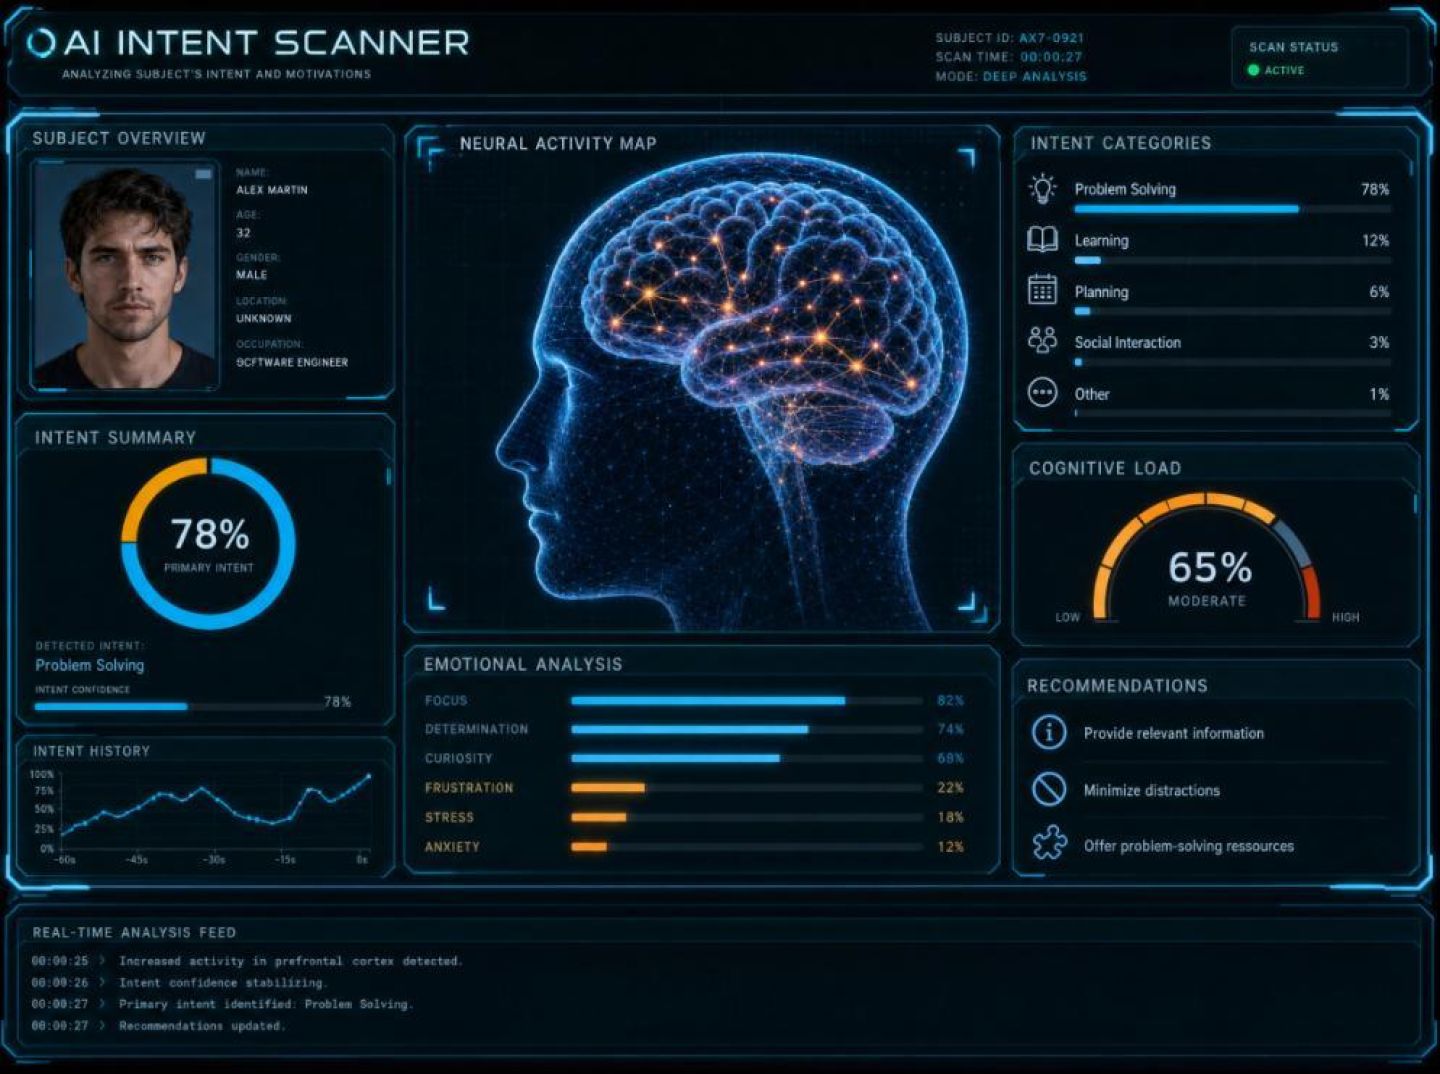
Anstrex больше не просто инструмент конкурентной разведки. При правильном использовании он превращается в ваш сканер ИИ-намерений — способ реконструировать вероятностную карту запросов, подходов и воронок, которые модели крупного языка неявно поддерживают в масштабе.
Вспомните, как работает расширение запросов: один вопрос на естественном языке порождает десятки фоновых поисковых запросов, после чего ИИ-ассистенты объединяют наиболее перекрывающиеся результаты в единый ответ. Как поясняет команда Ahrefs в своём разборе генерации с дополнительным поиском, итоговый ответ формируется из страниц, которые регулярно появляются во множестве подзапросов, а не из единственной страницы, случайно занимающей позицию №1 по одному конкретному формулировке. Аналогичная схема теперь наблюдается и в платных каналах: Gemini, система Advantage+ от Meta и ИИ-оптимизаторы TikTok запускают собственное внутреннее «расширение» на основе поведения пользователей, чтобы выбрать объявление, подход и посадочную страницу, которые получат шанс на клик.
Вы никогда не увидите эти скрытые подзапросы напрямую. Но вы можете увидеть их следы на рынке — наблюдая, какой креатив, хуки и воронки получают непропорционально высокий охват в сетях, нишах и регионах. Именно это делает Anstrex таким мощным инструментом для маркетологов, ориентированных на эффективность. Его функции шпионажа за рекламой позволяют просматривать тысячи активных кампаний и фильтровать их по продолжительности, частоте, стране, устройству и источнику трафика. Когда вы используете эти фильтры как "линзы намерений", а не как бесполезные фильтры, вы фактически создаете вероятностную карту графа пользовательских намерений, который усиливается системами ИИ.
Начните с широких контекстов, релевантных ИИ. Например, запросы, которые ИИ вроде ChatGPT склонны переформулировать с модификаторами, такими как «лучший», «обзоры», «2026», или даже «Reddit», согласно анализу пяти миллионов запросов на блоге Нила Пателя. В Anstrex это означает поиск рекламных креативов и прелендингов, которые активно используют те же модификаторы в своем тексте и на предварительных страницах продаж — «лучший инструмент для email-рассылок в B2B», «честные обзоры», «найдено на Reddit», «обновлено на 2026 год» и так далее. Когда вы видите одни и те же мотивы, многократно побеждающие у разных рекламодателей и в разных размещениях, вы замечаете не просто тренды — вы видите те подзапросы, которые ИИ отдает предпочтению, и те психологические установки, к которым покупатели привыкают.
Затем добавьте глубину воронки. Маркетологи корпоративного уровня, которые уже рассматривают переходы из поиска ИИ как пользователей “поздней стадии воронки с высокой степенью намерений”, демонстрируют лучшие результаты, как показало недавнее исследование 300 руководителей, описанное в отчете Search Engine Journal по корпоративному поиску с помощью ИИ. Вы можете воспроизвести эту логику в Anstrex, разделяя креативы, которые явно нацелены на начальное обучение (объяснительные подходы для осознания проблемы), от тех, которые предполагают глубокую предварительную подготовку (сравнительные таблицы, калькуляторы возврата инвестиций, предложения по миграции). Когда вы отслеживаете, какие воронки поддерживают расходы в течение длительных временных интервалов, вы, по сути, определяете, как пути обнаружения, сформированные ИИ, сокращают или удлиняют путь к покупке.
Со временем ваш рабочий процесс Anstrex должен всё меньше напоминать “поиск классной рекламы для копирования” и всё больше — “обучение ментальной модели современного покупателя, подверженного влиянию ИИ”. Например:
В совокупности эти кластеры формируют ваш рабочий граф, отражающий, как намерение кодируется и комбинируется на разных этапах воронки. Вы не узнаете точных фоновых запросов, которые выполняет та или иная ИИ-система, но это и не нужно. Ваша цель — вероятностная карта: живая, постоянно обновляемая картина того, какие формулировки проблем, наборы выгод и критерии принятия решений завышены в лентах и ответах ИИ, которые действительно видят ваши покупатели.
Как только вы её получите, Anstrex перестанет быть инструментом, позволяющим отслеживать действия конкурентов вчера. Он станет перспективным датчиком, показывающим, в каком направлении будет двигаться намерение, опосредованное ИИ, — и вы сможете выстроить свои подходы, креативы и воронки в соответствии с теми шаблонами, к которым машины уже подталкивают ваших потенциальных клиентов.
Получайте лучшие конверсионные лендинги каждую неделю на свою почту.
Обязательно к прочтению
Узнайте, как построить ответственный рабочий процесс конкурентной рекламной аналитики в условиях рекламного ландшафта, который все больше формируется искусственным интеллектом, метками раскрытия информации и цифровыми водяными знаками. Ознакомьтесь с тем, как анализировать использование ИИ конкурентами, выявлять творческие закономерности и разрабатывать этические рамки, способствующие прозрачным, соответствующим требованиям и отличающимся кампаниям.
Dan Smith
7 минокт. 23, 2026
Самое читаемое
Узнайте, как специалисты по performance-маркетингу могут создавать кросс-канальные пути верификации, превращая скептически настроенных потенциальных клиентов в уверенных покупателей на платформах TikTok, в native-, push- и pop-рекламе. Научитесь согласовывать креативные сообщения, укреплять доверие на каждом соприкосновении и измерять скрытое влияние фрагментированных путей клиента с помощью конкурентной рекламной аналитики.
Elena Morales
7 минокт. 20, 2026
Недавно обновлено
Samantha Reed
7 минокт. 18, 2026